01
What matters
In its November 5, 2026 account of AI memory codesign, NVIDIA reports gains of up to 10x and 30x in throughput per dollar across two platform comparisons. These are company-reported results for a named workload at specified per-user token rates, not general performance guarantees. NVIDIA presents them alongside changes in high-bandwidth memory (HBM) capacity per GPU.
02
Verified facts
- NVIDIA published its account of AI memory codesign on November 5, 2026.
- On the SemiAnalysis AgentX DeepSeek V4 Pro workload, NVIDIA says GB300 NVL72 delivers up to 10x higher throughput per dollar than its H200 platform.
- NVIDIA specifies that the GB300–H200 comparison uses 100 tokens per second per user, with HBM capacity per GPU roughly doubling.
- For the same named workload, NVIDIA says Vera Rubin NVL72 delivers up to 30x higher throughput per dollar than GB300 NVL72 at 125 tokens per second per user.
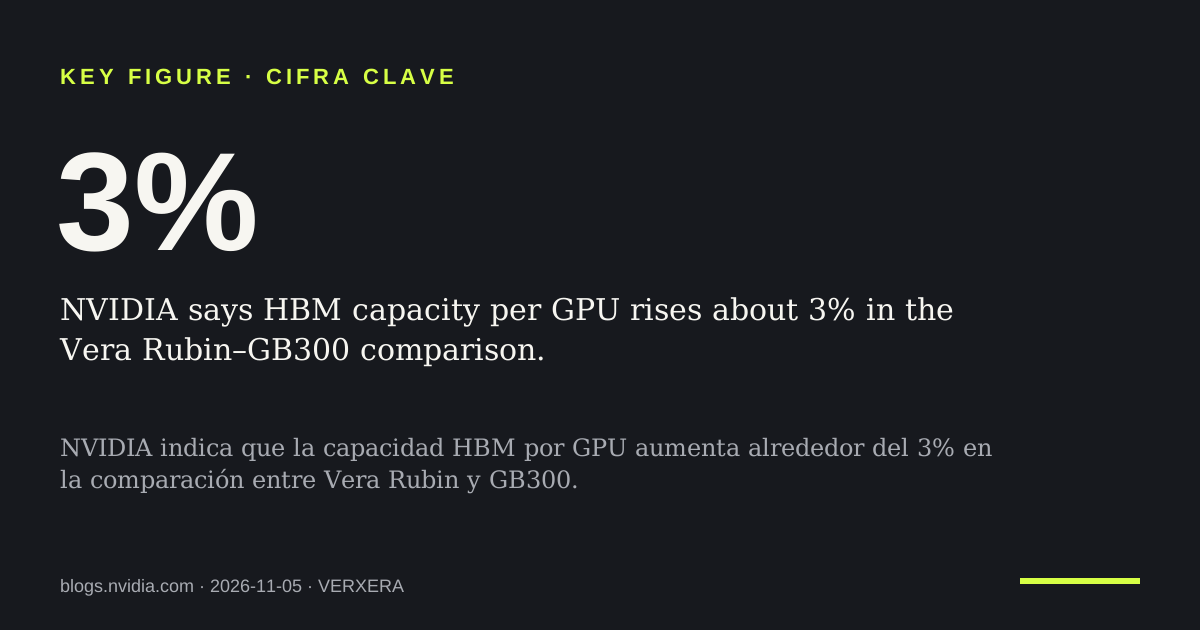
- NVIDIA says HBM capacity per GPU rises about 3% in the Vera Rubin–GB300 comparison.
- NVIDIA describes full-stack codesign as designing GPUs, CPUs, networking, storage and software together to obtain more useful work from memory.
03
Analysis
The comparisons have different platform baselines and different per-user token rates. They therefore describe two distinct comparisons, not a single common-condition progression. Throughput per dollar and memory capacity also measure different things: the reported performance multiples should not be read as equivalent increases in memory. NVIDIA’s codesign description sets out its approach; these figures alone do not isolate each component’s contribution.
04 · VERXERA view
Editorial opinionVERXERA opinion: NVIDIA’s November 5, 2026 account makes a specific case for looking beyond memory capacity alone. It reports up to 10x higher throughput per dollar for GB300 NVL72 versus H200 at 100 tokens per second per user, alongside roughly doubled HBM per GPU. For Vera Rubin NVL72 versus GB300, it reports up to 30x at 125 tokens per second per user with about 3% more HBM per GPU. Connecting those figures with NVIDIA’s description of coordinated hardware and software design explains the announcement’s significance: its argument concerns useful output relative to cost, not simply memory size. The strongest limitation is that these are company-reported, workload-specific maximum gains under different response-rate conditions. Deeper source reading is worthwhile for assessing those particular comparisons, rather than assuming universal gains.
This is VERXERA’s editorial interpretation, separated from the facts and analysis above. The reader keeps the final judgment.
05
Counterevidence and limits
This report rests on NVIDIA’s own announcement; the performance figures and publication date are the company’s statements.
06
Known uncertainties
How the reported maximum gains translate to workloads or per-user token rates beyond those named remains an open question.
01
Lo que importa
En su explicación del codiseño de memoria para IA del 5 de noviembre de 2026, NVIDIA comunica mejoras de hasta 10x y 30x en rendimiento por dólar en dos comparaciones de plataformas. Son resultados declarados por la empresa para una carga de trabajo concreta y tasas específicas de tokens por usuario, no garantías generales de rendimiento. NVIDIA los presenta junto con cambios en la capacidad de memoria de alto ancho de banda (HBM) por GPU.
02
Hechos verificados
- NVIDIA publicó su explicación del codiseño de memoria para IA el 5 de noviembre de 2026.
- En la carga de trabajo SemiAnalysis AgentX DeepSeek V4 Pro, NVIDIA afirma que GB300 NVL72 ofrece un rendimiento por dólar hasta 10 veces superior al de su plataforma H200.
- NVIDIA especifica que la comparación entre GB300 y H200 utiliza 100 tokens por segundo por usuario, mientras la capacidad HBM por GPU aproximadamente se duplica.
- Para esa misma carga de trabajo, NVIDIA afirma que Vera Rubin NVL72 ofrece un rendimiento por dólar hasta 30 veces superior al de GB300 NVL72, a 125 tokens por segundo por usuario.
- NVIDIA indica que la capacidad HBM por GPU aumenta alrededor del 3% en la comparación entre Vera Rubin y GB300.
- NVIDIA describe el codiseño integral como el diseño conjunto de GPU, CPU, redes, almacenamiento y software para obtener más trabajo útil de la memoria.
03
Análisis
Las comparaciones utilizan distintas plataformas de referencia y tasas de tokens por usuario. Por tanto, describen dos comparaciones diferentes, no una progresión bajo condiciones idénticas. El rendimiento por dólar y la capacidad de memoria también miden aspectos distintos: los múltiplos de rendimiento no equivalen a aumentos de memoria. La descripción del codiseño expone el enfoque de NVIDIA; estas cifras por sí solas no aíslan la contribución de cada componente.
04 · Opinión VERXERA
Opinión editorialOpinión de VERXERA: La explicación de NVIDIA del 5 de noviembre de 2026 plantea una razón concreta para mirar más allá de la capacidad de memoria. Comunica un rendimiento por dólar hasta 10 veces superior de GB300 NVL72 frente a H200 a 100 tokens por segundo por usuario, con aproximadamente el doble de HBM por GPU. Para Vera Rubin NVL72 frente a GB300, declara hasta 30 veces a 125 tokens por segundo por usuario, con alrededor del 3% más de HBM por GPU. Vincular estas cifras con el diseño coordinado de hardware y software explica su relevancia: el argumento trata de producción útil respecto al coste, no solo de memoria. La principal limitación son las mejoras máximas declaradas por la empresa para una carga específica y condiciones distintas. Profundizar en la fuente permite evaluar esas comparaciones concretas, no presumir mejoras universales.
Esta es la interpretación editorial de VERXERA, separada de los hechos y del análisis anteriores. El lector conserva la decisión final.
05
Contraste y límites
Este informe se basa en el anuncio de NVIDIA; las cifras de rendimiento y la fecha de publicación son declaraciones de la empresa.
06
Incertidumbres conocidas
Sigue abierta la cuestión de cómo se trasladan las mejoras máximas declaradas a otras cargas de trabajo o tasas de tokens por usuario.